TECH NOTE · CODEX CLI
Codex CLI로 자동화하는 것과 API를 직접 호출하는 것이 인증·비용·제어 면에서 어떻게 다른지 정리했습니다.
자동화의 기준이 다르다
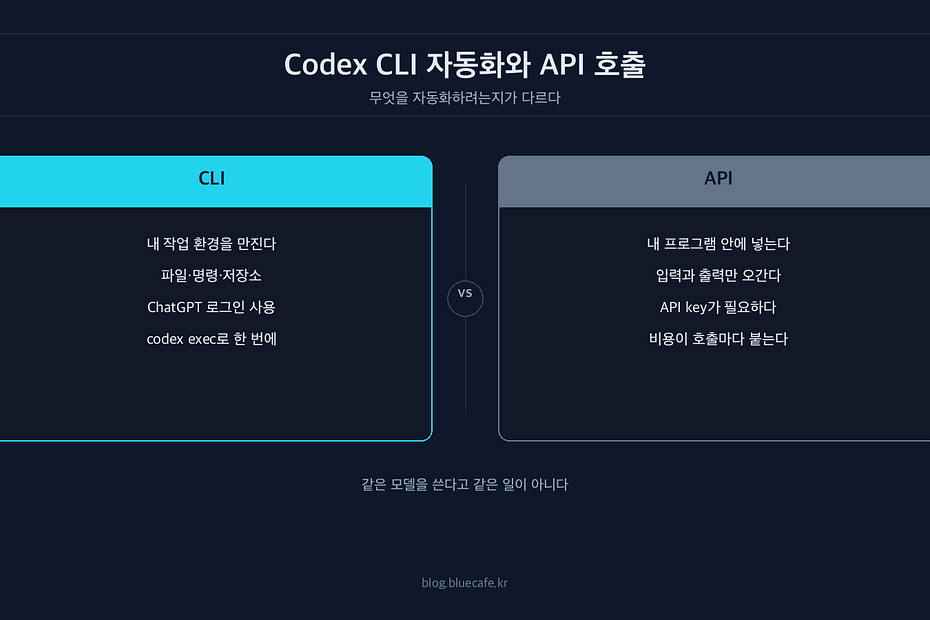
Codex CLI 자동화와 직접 API 호출의 차이는 “누가 작업 흐름을 들고 있느냐”에 있다. CLI는 내가 터미널에서 시키는 개발 작업을 Codex가 대신 굴려주는 쪽이고, API 호출은 내가 만든 프로그램이 OpenAI 모델을 필요한 순간에 부르는 쪽이다.
처음엔 둘 다 “AI한테 일을 시킨다”로 뭉뚱그려 보였다. 그런데 실제로 써보면 막히는 지점이 다르다. CLI는 로그인 상태, 작업 폴더, 권한, git 상태 같은 로컬 환경에서 많이 막히고, API는 키 관리, 요청 형식, 토큰 비용, 재시도 같은 운영 코드에서 막힌다.
| 구분 | Codex CLI 자동화 | 직접 API 호출 |
|---|---|---|
| 주 사용처 | 로컬 저장소 작업, 코드 수정, 리뷰, 반복 작업 | 서비스 기능, 배치 처리, 자체 자동화 로직 |
| 인증 감각 | ChatGPT 로그인 기반으로 시작하는 게 자연스럽다 | API key를 코드나 서버 환경에서 관리한다 |
| 비용 감각 | 내가 작업을 던지고 결과를 보는 흐름에 가깝다 | 요청마다 토큰과 모델 비용을 계산하게 된다 |
| 실패 지점 | 폴더, 권한, 로그인, sandbox, git 상태 | 키, rate limit, schema, 네트워크, 재시도 |
| 좋은 경우 | 사람이 터미널에서 하던 일을 대신 시킬 때 | 제품 안에 AI 기능을 넣거나 대량 처리할 때 |
CLI는 “내 작업 환경”을 대신 만진다
Codex CLI는 API 래퍼라기보다, 내 로컬 작업 공간에 들어와서 일을 하는 도구에 가깝다. 그래서 제일 먼저 봐야 하는 건 모델보다 현재 터미널이 어디를 보고 있는지다. 내 경우에는 성능 문제가 아니라 엉뚱한 폴더에서 돌린 게 원인이었던 적이 더 많았다.
로그인도 마찬가지다. Codex CLI 글에서는 보통 API key부터 꺼내면 흐름이 꼬인다. 일반적인 설치와 초기 사용은 codex login으로 ChatGPT 계정에 로그인하는 쪽이 기본 경로다. API key는 직접 OpenAI API를 호출하거나, CI 같은 특수 자동화에서 따로 다룰 문제에 가깝다.
로그인 상태가 헷갈리면 이 정도만 먼저 본다.
codex login status내 환경에서는 이 명령이 ChatGPT 로그인 상태를 보여줬다. 여기서 이미 로그인되어 있는데도 결과가 이상하면, 다음 의심 대상은 계정이 아니라 작업 폴더나 권한이다. 괜히 다시 로그인부터 하면 문제를 더 흐릴 때가 있다.
`codex exec`는 한 번에 던질 때 편하다
대화형 CLI는 중간에 말을 주고받을 일이 있을 때 편하다. 반대로 “이 파일들 기준으로 리뷰해줘”, “이 명령 실패 원인 찾아줘”처럼 한 번에 던지고 결과만 받고 싶은 일은 codex exec 쪽이 맞는다.
도움말을 보면 이 차이가 꽤 노골적으로 보인다.
codex exec --helpexec는 비대화형 실행이다. 그러니까 내가 이미 작업 범위를 알고 있고, 중간 선택지가 별로 없을 때 쓰기 좋다. 글 초안 변환, 단순 코드 리뷰, 정해진 검증 명령 실행 같은 일은 이쪽이 덜 번거롭다.
반대로 요구사항이 자꾸 바뀌거나, 중간 결과를 보고 방향을 바꿔야 하면 대화형 세션이 낫다. 처음엔 모든 걸 exec로 자동화하고 싶었는데, 막상 써보면 자동화할 수 있는 일과 대화로 풀어야 하는 일이 갈린다.
API 호출은 “내 프로그램” 안에 넣는 일이다
직접 API 호출은 느낌이 완전히 다르다. 여기서는 Codex가 내 저장소를 알아서 뒤지는 게 아니라, 내가 요청을 만들어서 OpenAI API에 보내고 응답을 받아 처리한다. 이때부터는 AI 도구 사용이라기보다 백엔드 기능 하나를 붙이는 작업이 된다.
예를 들어 블로그 초안을 자동으로 다듬는 서비스를 만든다고 치면, CLI는 내가 터미널에서 “이 글 다듬어줘” 하고 시키는 방식이다. API는 업로드된 원고를 서버가 받아서, 모델에 보내고, 결과를 저장하고, 실패하면 재시도하고, 비용을 기록하는 방식이다.
여기서 API key가 등장한다. 다만 이건 Codex CLI를 처음 설치하는 글에서 먼저 꺼낼 이야기는 아니다. API key는 “내 코드가 OpenAI API를 직접 호출해야 한다”는 요구가 생겼을 때 다루면 된다.
비용 감각도 다르게 잡힌다
CLI는 작업 단위로 생각하게 된다. “이 브랜치 리뷰 한 번”, “이 에러 원인 분석 한 번”, “이 문서 초안 정리 한 번” 같은 식이다. 물론 내부적으로는 모델 사용량이 있지만, 내가 체감하는 단위는 작업이다.
API는 요청 단위로 생각하게 된다. 입력이 얼마나 길었는지, 출력이 얼마나 나왔는지, 같은 요청을 몇 번 반복했는지, 실패 재시도까지 포함하면 하루에 얼마나 나가는지가 바로 운영 문제가 된다.
내 경우에는 이 차이를 늦게 잡았다. CLI에서 편하게 되던 작업을 그대로 API로 옮기면, 갑자기 저장, 중복 실행 방지, 로그, 비용 추적 같은 것들이 따라붙는다. “AI가 답을 잘하느냐”보다 “이 호출이 언제, 몇 번, 왜 나갔느냐”가 더 중요해진다.
실패를 보는 순서도 다르다
CLI가 이상할 때는 로컬 상태부터 본다.
- 지금 맞는 저장소에서 돌렸는가
- 로그인은 ChatGPT 계정으로 되어 있는가
- Codex가 파일을 읽거나 쓸 권한이 있는가
- sandbox나 approval 설정이 작업을 막고 있는가
- git 작업물이 이미 꼬여 있지는 않은가
API가 이상할 때는 요청과 운영 조건을 본다.
- API key가 맞는 환경에 들어가 있는가
- 요청 JSON이 현재 API 형식에 맞는가
- 모델 이름과 옵션이 맞는가
- rate limit이나 spend limit에 걸린 건 아닌가
- 실패했을 때 같은 요청을 중복 처리하지 않는가
여기서 헷갈리면 시간을 많이 쓴다. CLI 문제를 API key 문제처럼 보고, API 문제를 Codex 로그인 문제처럼 보면 삽질이 길어진다.
어느 쪽을 써야 할지 헷갈릴 때
처음엔 기능 이름보다 작업의 주인이 누구인지 보면 쉽다.
| 상황 | 고르는 쪽 |
|---|---|
| 내가 터미널에서 하던 개발 작업을 맡기고 싶다 | Codex CLI |
| 저장소를 읽고 수정하고 테스트까지 돌리게 하고 싶다 | Codex CLI |
| 서비스 사용자 요청마다 AI 응답을 만들어야 한다 | 직접 API 호출 |
| 배치 작업에서 수천 개 문서를 처리해야 한다 | 직접 API 호출 |
| CI나 내부 도구에서 정해진 입력을 넣고 결과를 받아야 한다 | 직접 API 호출 또는 codex exec, 범위에 따라 다름 |
애매한 건 마지막 줄이다. CI에서 코드 리뷰를 돌리는 식이면 Codex CLI 자동화가 자연스럽고, 문서 1만 개를 요약해서 DB에 넣는 식이면 API가 자연스럽다. 둘 다 자동화지만, 한쪽은 작업자를 자동화하는 느낌이고 다른 한쪽은 기능을 만드는 느낌이다.
같이 나오는 질문
API key 없이 Codex CLI를 써도 되나
된다. 일반적인 Codex CLI 사용은 ChatGPT 로그인으로 시작하는 게 자연스럽다. API key는 직접 OpenAI API를 호출하거나, 별도 자동화 환경에서 키 기반 인증이 필요할 때 꺼내면 된다.
CLI로 되던 일을 전부 API로 바꾸면 좋은가
꼭 그렇지는 않다. API로 바꾸는 순간 내가 워크플로, 상태 저장, 실패 처리, 비용 추적을 직접 가져간다. 한두 번 사람이 검토하면서 돌릴 일이라면 CLI가 더 단순하다.
처음에 뭘 확인하면 덜 헷갈리나
먼저 codex login status로 CLI 로그인 상태를 보고, 그다음 현재 폴더와 권한을 본다. API 쪽이면 로그인 상태보다 API key가 들어간 환경, 요청 형식, 사용량 제한부터 보는 게 빠르다.
사실관계는 OpenAI의 Codex 인증 문서와 OpenAI API 텍스트 생성 문서를 기준으로 맞췄다: https://developers.openai.com/codex/auth, https://developers.openai.com/api/docs/guides/text?api-mode=responses